FEV 2024 — MAI 2026 · coprodux
coprodux
SaaS B2B multitenant de planejamento de comunicação, construído solo do zero sobre Directus + PostgreSQL: motor de campanhas próprio, RAG híbrido e billing por projeto, com 25 clientes pagantes e R$60.000 captados.
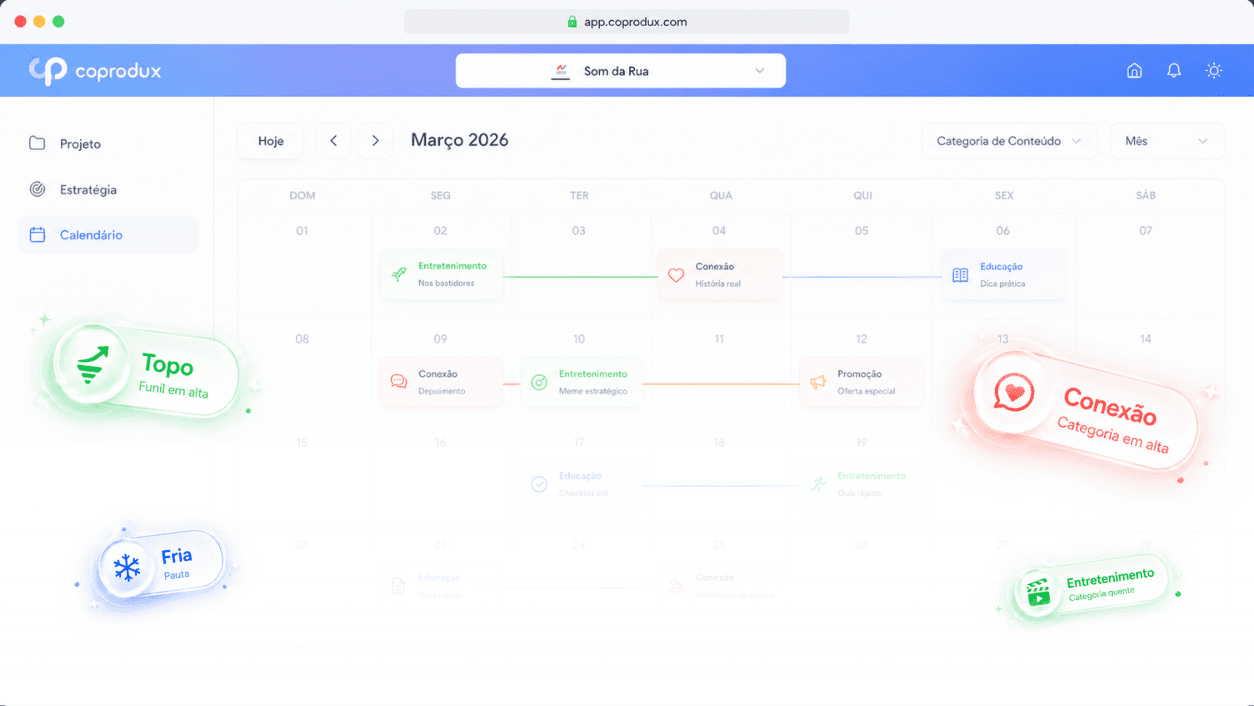
O produto
A coprodux é uma plataforma SaaS B2B de planejamento de comunicação para agências e equipes de marketing, construída para transformar estratégia em algo visível, compartilhado e executável por toda a equipe. O fluxo do produto conecta Meta → Campanha → Calendário → Narrativa → Briefing. Cada etapa é estruturada e executável, sem depender de planilhas ou documentos desconectados.
Como fundador técnico, arquitetei e implementei sozinho toda a stack do produto (banco de dados, backend, frontend, infraestrutura de nuvem e pipeline de IA em produção), sem terceirizar nenhuma decisão técnica. Também conduzi discovery com clientes reais e priorizei o roadmap, mas a espinha dorsal do projeto foi a engenharia.
Arquitetura e stack
- ▹Backend: Directus (plataforma de dados headless) sobre PostgreSQL, com toda a lógica de negócio em duas extensões próprias em TypeScript — um pacote com cerca de 100 endpoints custom e um pacote de hooks plugado no ciclo de vida nativo do Directus (autenticação, criação/atualização de registros).
- ▹Frontend: Next.js + React + Tailwind, consumindo a API via um cliente TanStack Query 100% tipado, gerado automaticamente a partir do OpenAPI que o próprio Directus expõe do schema do banco.
- ▹Cache e filas: Redis, usado pela camada de cache do Directus e pela orquestração de processamento assíncrono.
- ▹Deploy: GitHub Actions builda as duas extensões, empacota a imagem Docker, publica no GHCR e faz deploy via SSH num VPS próprio atrás de Traefik, com certificado TLS emitido pela Cloudflare, backup do banco pré-deploy e checagem de integridade (contagem de tabelas e usuários) pós-deploy.
Optei por Directus como camada de dados/autenticação/permissões em vez de escrever um backend CRUD do zero: ele gera API REST/GraphQL, painel administrativo e RBAC direto do schema do Postgres. Isso libera a engenharia própria pra focar no que é realmente diferencial do produto — motor de campanhas, geração por IA, scraping e orquestração de processamento —, tudo construído como extensões custom por cima da base que o Directus resolve de fábrica.
Multitenancy, autenticação e billing
- ▹Cada conta (tenant) e cada projeto têm sua própria tabela de vínculo com papéis dedicados —
ACCOUNT_OWNER/MANAGER/MEMBERno nível de conta ePROJECT_OWNER/MANAGER/EDITOR/VIEWERno nível de projeto —, uma camada de controle de acesso construída em cima do RBAC nativo do Directus, não em substituição a ele. - ▹Autenticação via Clerk: um hook substitui o
authenticatenativo do Directus, valida o JWT do Clerk, localiza o usuário correspondente por um campo customizado (clerk_user_id) e monta manualmente o objeto deAccountabilityque o Directus usa pra aplicar as próprias permissões. Clerk resolve identidade; toda autorização a partir daí é RBAC do Directus. - ▹Novos usuários são provisionados via webhook do Clerk, que cria o usuário no Directus e replica o avatar pro storage próprio.
- ▹Billing por uso via Stripe: cobrança por quantidade de projetos, com saldo de tokens de IA por projeto.
Motor de campanhas e automações
Boa parte do valor do produto está nas extensões custom por cima do Directus, não em nada que ele já entrega de fábrica:
- ▹Motor de campanhas: distribuição algorítmica (não por LLM) de pautas num calendário editorial, combinando peso por categoria de conteúdo, estágio de funil e distribuição temporal — o motor por trás das telas de temperatura das pautas e categorias de conteúdo do produto.
- ▹Geração e otimização de campos por IA: endpoints com Azure OpenAI (GPT-4.1-mini) via streaming SSE, preenchendo e reescrevendo campos do perfil da empresa token a token em tempo real.
- ▹Scraping de onboarding: Puppeteer, Firecrawl e um scraper de Instagram via Apify, com cache, retry e tratamento de cookie banners, populando automaticamente o perfil estratégico de uma empresa a partir do site e das redes dela.
- ▹Orquestração de processamento: sessões de processamento assíncrono com pausa, cancelamento, retomada e checkpoints por etapa/módulo, persistidas em Postgres e aceleradas por Redis — é o que roda por trás da tela de arquivo em produção e do workflow de publicação em 7 passos do briefing.
Reescrita: de NestJS/MongoDB para Directus/PostgreSQL
A plataforma hoje em produção é uma reescrita completa do segundo MVP, que rodava em NestJS e MongoDB. Migrei o banco principal de MongoDB para PostgreSQL em duas semanas, sem downtime, e consolidei backend, autenticação e permissões em cima do Directus no mesmo processo — não foi só trocar o banco, foi trocar a fundação inteira da plataforma. A mudança desbloqueou o algoritmo central de inteligência do produto, que dependia de relações e queries que o modelo de documentos do Mongo não suportava bem conforme o produto crescia.
IA generativa e RAG híbrido
Avaliei três provedores de IA generativa (OpenAI, Anthropic/Claude e Azure AI Foundry) ao longo da evolução do produto, até decidir pelo Azure AI Foundry como stack de IA principal — usado tanto na geração/otimização de campos por IA (acima) quanto no pipeline de RAG.
Construí um pipeline de RAG híbrido (busca vetorial combinada com grafo de conhecimento) isolado em um microsserviço próprio em Python, o noctria, separado da plataforma principal por diferença de perfil de custo de nuvem. A camada evoluiu de Qdrant para PostgreSQL/PGVector no lado vetorial, combinada com Neo4j no lado de grafo, alimentando as funcionalidades de IA generativa do produto com 98% de adoção pela base de usuários.
Testes, CI/CD e qualidade
- ▹Cobertura de testes unitários, de integração e end-to-end antes de cada pull request
- ▹Lint e formatting automatizados (Biome), reforçados especificamente pelo padrão inconsistente de código gerado por IA
- ▹Code review com CodeRabbit (revisão automatizada por IA) antes do merge na main
- ▹Pipeline de deploy com backup do banco pré-deploy e checagem de integridade pós-deploy (contagem de tabelas/usuários e health check)
- ▹Observabilidade em produção via Microsoft Clarity e Sentry
Resultados
- ▹25 clientes pagantes adquiridos via processo estruturado de discovery (150+ entrevistas), com 18% de conversão de lead para pagante
- ▹Centenas de usuários na base, com roadmap de evolução contínua
- ▹R$ 60.000 captados em aporte para desenvolvimento do produto
- ▹Time multidisciplinar de até 13 pessoas liderado com Scrum e Kanban
- ▹2 Prêmios Nacionais como SaaS de Comunicação (Inovativa Brasil e Ibmec Hubs)